Software & AI29 settembre 2026
Oltre il chatbot: quando un piccolo modello AI deve decidere, non scrivere
Molti sistemi aziendali non hanno bisogno di generare testo a ogni passaggio. Hanno bisogno di prendere una decisione. I3K sperimenta Decision Model locali con EuLLM: una demo da circa 8 ms per decisione mostra come piccoli modelli AI possano controllare agenti, RAG e workflow aziendali.
Oltre la generazione di testo
Quando si parla di Large Language Model, il primo pensiero va quasi inevitabilmente a ChatGPT e alla generazione di testo. Domande, risposte, documenti, riassunti, codice.
È soltanto una parte del problema.
Molti sistemi aziendali non hanno bisogno di generare testo a ogni passaggio. Hanno bisogno di prendere una decisione.
· Quale strumento deve utilizzare un agente AI?
· Le informazioni recuperate da un sistema RAG sono sufficienti?
· Una richiesta deve essere gestita automaticamente oppure passata a un operatore?
· Un evento di sicurezza merita un approfondimento?
· Qual è il prossimo passaggio di un workflow?
I3K sta sperimentando questo modello di utilizzo attraverso EuLLM, la propria piattaforma open source per l'esecuzione e la specializzazione locale dei modelli.
Circa 8 millisecondi per prendere una decisione
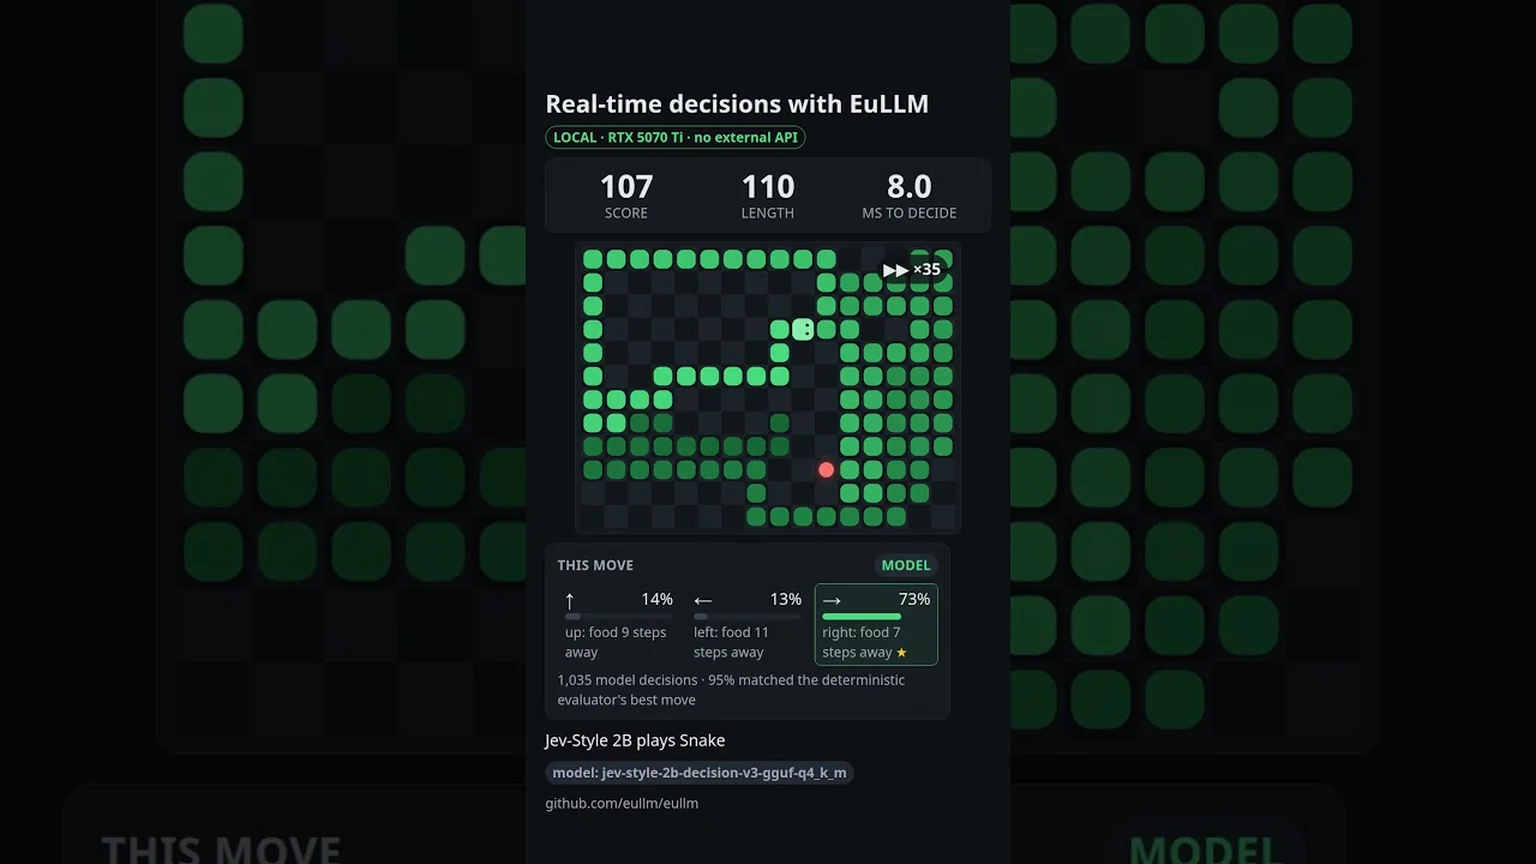
Una delle demo più recenti utilizza un piccolo Jev-style Decision Model da 2 miliardi di parametri per controllare in tempo reale il gioco Snake. Il gioco è la parte meno importante dell'esperimento.
Ad ogni movimento il modello riceve lo stato corrente, valuta le azioni disponibili e seleziona quella che ritiene migliore. Il test viene eseguito completamente in locale su una NVIDIA RTX 5070 Ti. La latenza osservata nella demo è nell'ordine degli 8 millisecondi per decisione.
Accanto al modello è stato implementato un valutatore deterministico, capace di individuare autonomamente la scelta migliore per quella particolare configurazione del gioco. Nel test mostrato dalla demo, circa il 95% delle decisioni del modello coincide con la scelta indicata dal valutatore.
Non è quindi una percentuale generica di accuratezza attribuita da un secondo LLM. È un confronto con una logica deterministica specifica per il problema.
I valori riportati sono osservazioni di questa demo su questo hardware, non benchmark certificati.
Perché Snake?
Perché rende visibile un concetto normalmente nascosto all'interno dei software. Quando il modello decide di andare a destra, il risultato della decisione appare immediatamente sullo schermo.
In un'applicazione aziendale la stessa logica potrebbe decidere qualcosa di molto meno spettacolare ma decisamente più utile.
· Un agente potrebbe decidere di interrogare una seconda fonte prima di rispondere.
· Un sistema documentale potrebbe stabilire che le evidenze disponibili non sono sufficienti.
· Un processo amministrativo potrebbe scegliere tra elaborazione automatica ed escalation verso un operatore.
· Un sistema di cybersecurity potrebbe classificare un evento e scegliere il livello successivo di analisi.
Il modello non deve necessariamente produrre una risposta articolata. Deve scegliere correttamente tra un insieme di azioni.
Il problema di utilizzare modelli enormi per decisioni minuscole
Molte architetture AI contemporanee utilizzano modelli general-purpose molto grandi anche per passaggi relativamente semplici. Il modello riceve il contesto, ragiona e restituisce magari una singola parola:
continue

oppure

escalate
Dal punto di vista tecnico funziona. Dal punto di vista architetturale non è sempre efficiente. Ogni chiamata può significare latenza di rete, consumo di token, costi variabili e trasferimento di informazioni verso un'infrastruttura esterna. Se il workflow contiene decine di passaggi, il problema si moltiplica. Un modello piccolo e specializzato può rappresentare un'alternativa interessante. Non deve conoscere tutto. Deve conoscere molto bene il proprio compito.
Dal generative AI al decision layer
Una possibile architettura futura dell'AI aziendale separa funzioni che oggi vengono affidate allo stesso modello. I modelli più potenti possono continuare a occuparsi dei problemi che richiedono vera capacità generativa e ragionamento complesso. Modelli più piccoli possono invece gestire classificazione, routing e decisioni ripetitive. In mezzo rimane l'applicazione.
È una struttura particolarmente interessante per agenti e sistemi RAG, dove il modello viene chiamato numerose volte durante l'esecuzione di una singola richiesta.
Pensiamo a un RAG aziendale. La prima ricerca restituisce quattro documenti. Il sistema può generarne immediatamente una risposta oppure chiedere a un piccolo decision model: le informazioni recuperate sono sufficienti?
Se la risposta è negativa, può avviare un secondo retrieval. Lo stesso modello potrebbe determinare quale archivio interrogare oppure se chiedere chiarimenti all'utente. Il modello generativo principale viene coinvolto soltanto quando serve realmente.
AI locale significa anche controllo dell'infrastruttura
Nella demo EuLLM non viene utilizzata alcuna API esterna. Modello, dati e inferenza restano sulla macchina locale. Questo aspetto diventa particolarmente importante negli ambienti enterprise.
L'esigenza non riguarda soltanto la privacy. Una piattaforma locale permette di conoscere l'hardware che esegue il modello, controllare le versioni, stabilire le policy di aggiornamento e mantenere prevedibile il comportamento dell'infrastruttura.
La latenza non dipende dalla connessione Internet. Un'interruzione di un provider esterno non blocca necessariamente il processo. E il costo dell'inferenza non cresce linearmente con ogni singola chiamata verso un'API commerciale.
EuLLM: Engine, Forge e Hub
EuLLM nasce con un'architettura più ampia del semplice inference server.
Engine
Il runtime che permette di eseguire modelli localmente.Forge
Dedicato alla verticalizzazione e ai processi teacher-student, con l'obiettivo di trasformare modelli generalisti più grandi in modelli più piccoli e specializzati.Hub
Pensato come livello europeo per distribuzione, catalogazione e informazioni sui modelli. I Decision Model rappresentano quindi un caso particolarmente naturale per l'intero ecosistema. Un modello grande può contribuire alla produzione di uno studente specializzato. Forge gestisce il processo di specializzazione. Engine esegue il risultato sull'infrastruttura del cliente. Il codice è su GitHub.Non tutto deve essere un chatbot
Probabilmente è questa la conclusione più interessante della demo. Negli ultimi anni abbiamo associato gli LLM all'interfaccia conversazionale.
Ma un modello linguistico può diventare un componente interno di un software senza che l'utente debba mai parlarci. Può osservare. Interpretare. Decidere. E passare l'esecuzione al componente successivo.
In molti casi, il futuro dell'AI aziendale potrebbe essere meno visibile di quanto immaginiamo. Meno finestre di chat. Più modelli specializzati all'interno dei processi.
La partita di Snake serve soltanto a mostrarli mentre lavorano.
Per chi volesse portare questo tipo di infrastruttura in azienda, la gamma di appliance è descritta nella pagina I3K Local AI.
Interessato?
Contattaci per ricevere un preventivo personalizzato.
Tutti gli articoli
I3K Technologies Srl a socio unico — i3k.eu